pstack 完整指南(下)
在上一篇里,我讲了为什么验证是我和 agent 做任何事的地基,以及怎样着手写你自己的验证 skill。核心结论只有一条。agent 如果不能验证自己的工作,其他一切都不重要。你仍然是瓶颈,一整天都会耗在给 agent 当保姆上。
https://x.com/i/status/2094457600259842065
但验证跑通之后,下一个问题是,你究竟怎么搞清楚该建什么?
这篇文章里,我会带你走一遍我用 pstack 做调研、规划、原型和架构的方式。这就是让我每月把上千个 PR 送进生产环境、同时把代码质量维持在极高水准的那套工作流。
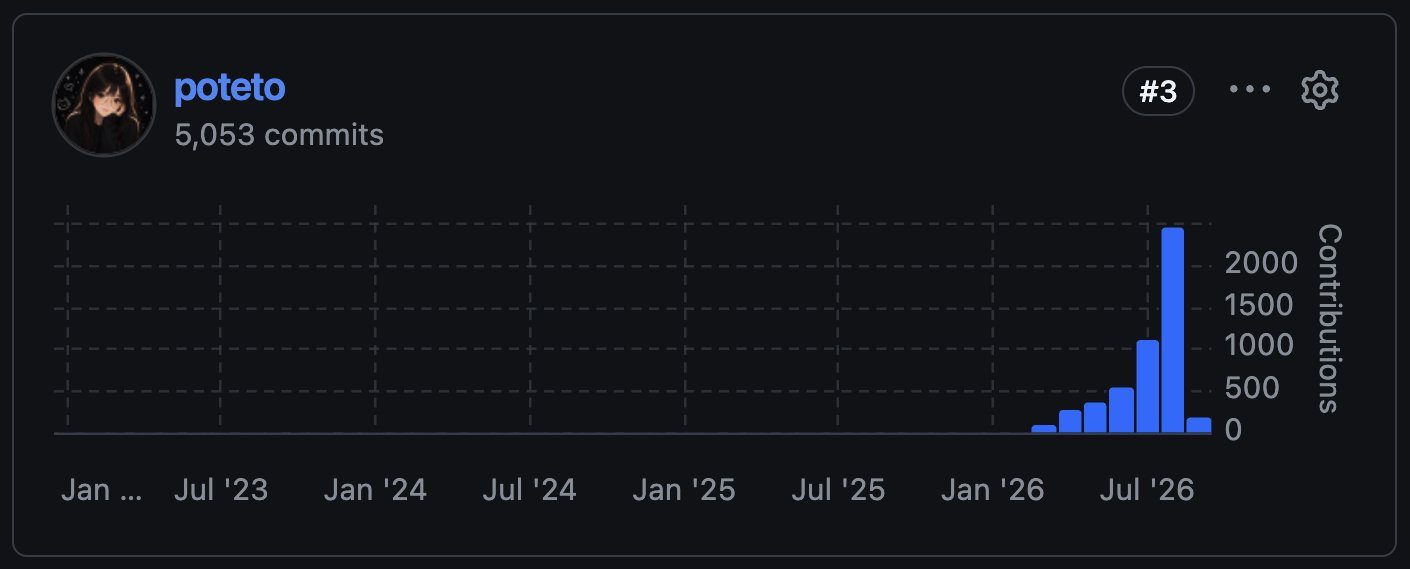
八月收尾时,已有 2,462 个 PR 进了生产环境
监督比你聪明的人,是一门手艺
Section titled “监督比你聪明的人,是一门手艺”回到 2024 年那个古早年代,想改动一个系统里的任何东西,你得先读够多的代码,才能建立起关于它如何运转的心智模型。视代码库的规模与复杂度而定,这可能花掉你几小时,也可能是几天甚至几个月。改动很小时,你或许只靠对某个小子系统的局部理解就能蒙混过关。但如果你在重构核心,为了把重构做对、做得有效,你大概需要一个关于整体如何运转的心智模型。
agent 显然把这道门槛拿掉了。你只要给 agent 提示,它就能改动系统,不管你对这份代码了解多少。但把代码质量和用户体验维持在高位依然很难,尤其当你本来就不是那个知道该看什么、该问什么的领域专家。
即便前沿模型已经非常能干,我仍然反复观察到两种失败模式:
- 它们无法完整理解你的意图,因为意图本身欠规格,或者规格写得很差。
- 它们没有足够的上下文,不知道怎么把活干对。
这两个问题是相关的。用好 agent,归根到底取决于你能否用高质量的上下文把 agent 的 context window 预热好。不做这件事当然也能写出能跑的代码,但我发现,当我花了功夫把 agent 需要的一切都备齐之后,结果和质量都会好得多。
用它自己的话说
Section titled “用它自己的话说”前沿模型是非常能干的程序员。面对更老的模型,我可能会极其具体地规定它做什么,近乎微管理;而最新的模型写代码比你我都好。所以我想拿捏一个分寸,既告诉 agent 我要达成什么,又留给它自由,让它用我没想到的方式去解。
这就是那门手艺。监督一个比你聪明的人,在一份不是你写的代码库上工作,而人类已经没法把整个代码库的心智模型装进脑子里。
我喜欢用的一个技巧是间接提示。与其直接告诉 agent 我想要什么,我试着把它从 agent 那里引出来,用它自己的话。
比如有人在 Slack 上报了问题,我常常会让 agent 先读完整个 thread,在动手做任何事之前,用它自己的话把问题重述一遍。
我可能会这么说:
/poteto-mode 读这个 slack thread。用你自己的话、用大白话重述一遍,你认为根本问题是什么
这做到了三件事。
第一,它逼 agent 把一段嘈杂的对话压缩成结构化的问题陈述。第二,它让我立刻抓到误解。如果 agent 死盯着 thread 里某条无关线索,我可以在它开始写代码之前迅速纠偏。
第三,我没有用自己的假设和猜想把它带偏,而那些假设可能是错的,也可能限制住 agent 本来能达到的高度。
建立心智模型
让 agent 用你能听懂的方式复述,是与比你聪明的人共事的重要一环。这正是 /teach 的灵感来源,这个 skill 帮你的 agent 用直觉化的方式把事情讲清楚。每当我需要确认 agent 正在做的事情对我而言说得通,我就会用它。
/how 追踪运行时机制。当你问 /how,agent 会评估子系统的复杂度。如果子系统横跨多个目录或服务,它会在 Grok 这类又快又省的模型上 spawn 并行的 explorer agent。
/how 虚拟化是怎么实现的?
/why 调查动机与意图。代码告诉你发生了什么,却很少告诉你某人为什么那样写。当你运行 /why,pstack 会并行查询多个来源的历史证据:Git 历史与 PR review 评论、Linear 工单、Notion 设计文档、Slack 对话、Datadog 监控、Sentry 报错、代码血缘,以及分析数仓里的事件。
/why 我们为什么还卡在旧版本的 node.js 上?
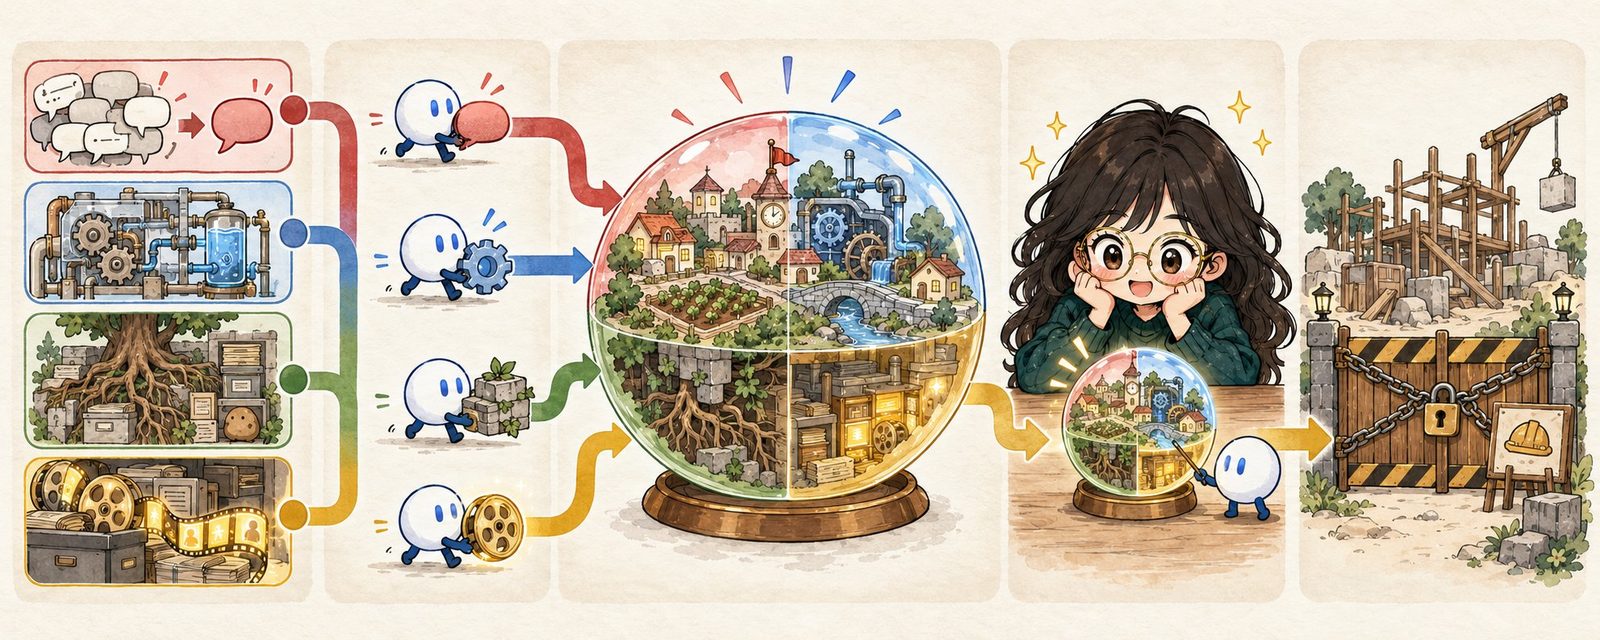
每当我想让 agent 复述某件事,好让我更好地理解并信任它的工作,我就会用 /teach。
/teach 我,为什么你用这种方式实现而不是 <另一种方式>。你做了哪些权衡,为什么?
实践中我还发现,/teach skill 做的调研不只对人类有用,对 agent 也有用。即便用上最新的前沿模型(这也取决于 harness 的质量),总体上我发现它们仍然常常自信地下结论,却不拿数据支撑,也没真去读那些建立运作心智模型所必需的代码。所以这个「教给你它要做什么、为什么这么做」的动作,最后也帮到了 agent 自己。
从历史中学习
我的很多项目会跨越多次对话。比如几个月前,我在修大家反馈的 Cursor 虚拟化 bug 和性能问题。我意识到,每开一个新 chat,我基本都得从头来过,重新堆起 agent 之前解类似问题时已经拥有的那份丰富上下文。
我意识到的是,你过去的 transcript 往往是丰富上下文的金矿。pstack 自带 /recall skill,把你最近的上下文从聊天历史里拉回来,这样即使是全新的 agent 也能拿到它需要的上下文,迅速回到好的状态。
/recall 我昨天在虚拟化上做的工作,然后读一下 slack 上这份 bug 报告
用 /teach、/recall、/how 和 /why,是我让自己对代码库的心智模型保持更新的方式,并把它压缩成我容易理解、容易记住的形态。而且,它对 agent 也有帮助!
理解了问题之后,解法该怎么规格化?
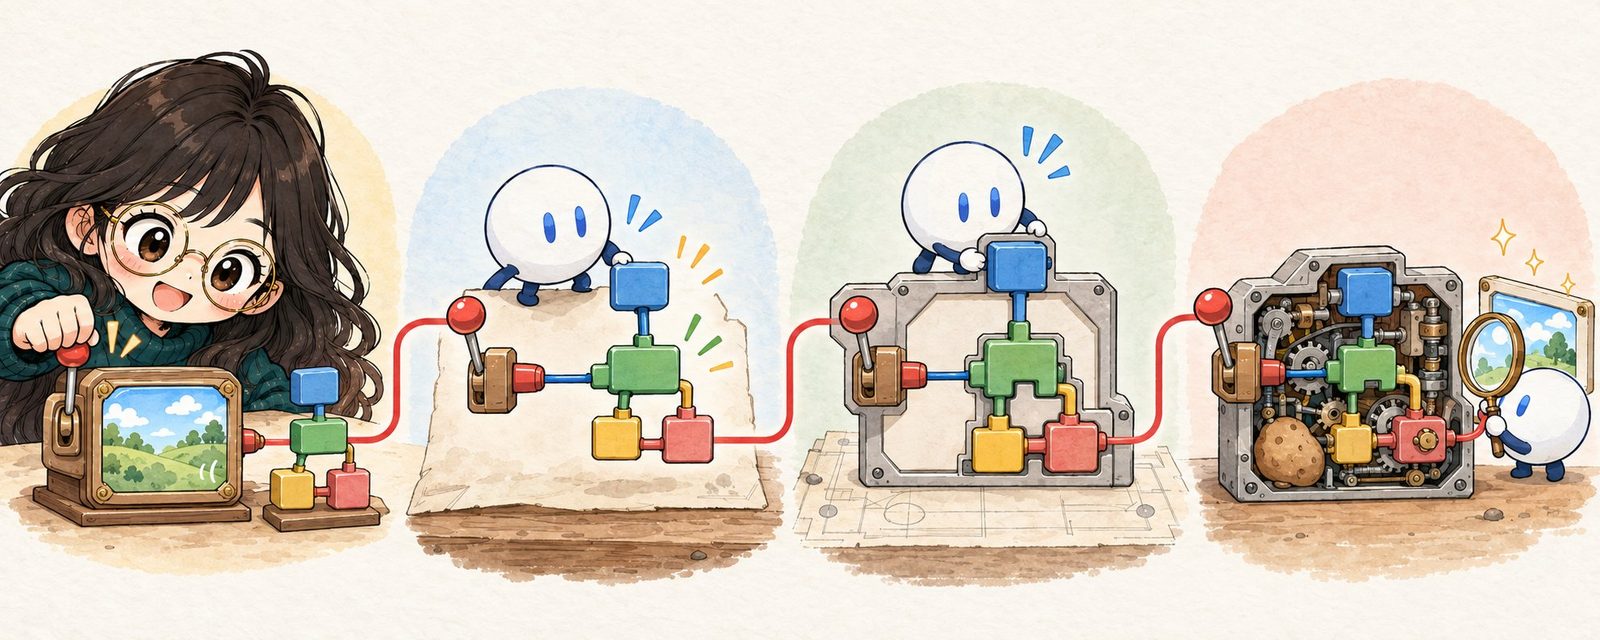
在我看来,大多数带 plan mode 的 harness 倾向于把实现细节写得过细,而其他一切都写得过粗。所以我在 pstack 里才半开玩笑地说「我不相信规划」。实情是我当然规划,只不过我用代码来规划。
对某些类型的工作,比如创建别人要用的共享代码或包,我非常信奉 readme 驱动开发。如果你不熟悉,这是当年流行过的一种开发手法,你先把 readme 写出来。这逼着你戴上开发者体验的帽子,从向一个假想用户描述 API 开始,再倒推回实现与架构。
比如我做 Dune 的时候,那是我们自研的桌面应用客户端框架,我先给它写了一份 tutorial,好让我体会用它搭应用是什么感觉。至少我试过。让 agent 产出任何像样、可读的东西都是一场苦战。所以我得先花点时间磨刀,做出了 /technical-writing skill。
没有 /technical-writing 的那版 readme 读起来很痛苦,因为它把不同目标混成了一锅。它同时想当 tutorial、how-to 指南、架构说明和 API 参考,还带着那股熟悉的 AI slop 味和做作的文风。
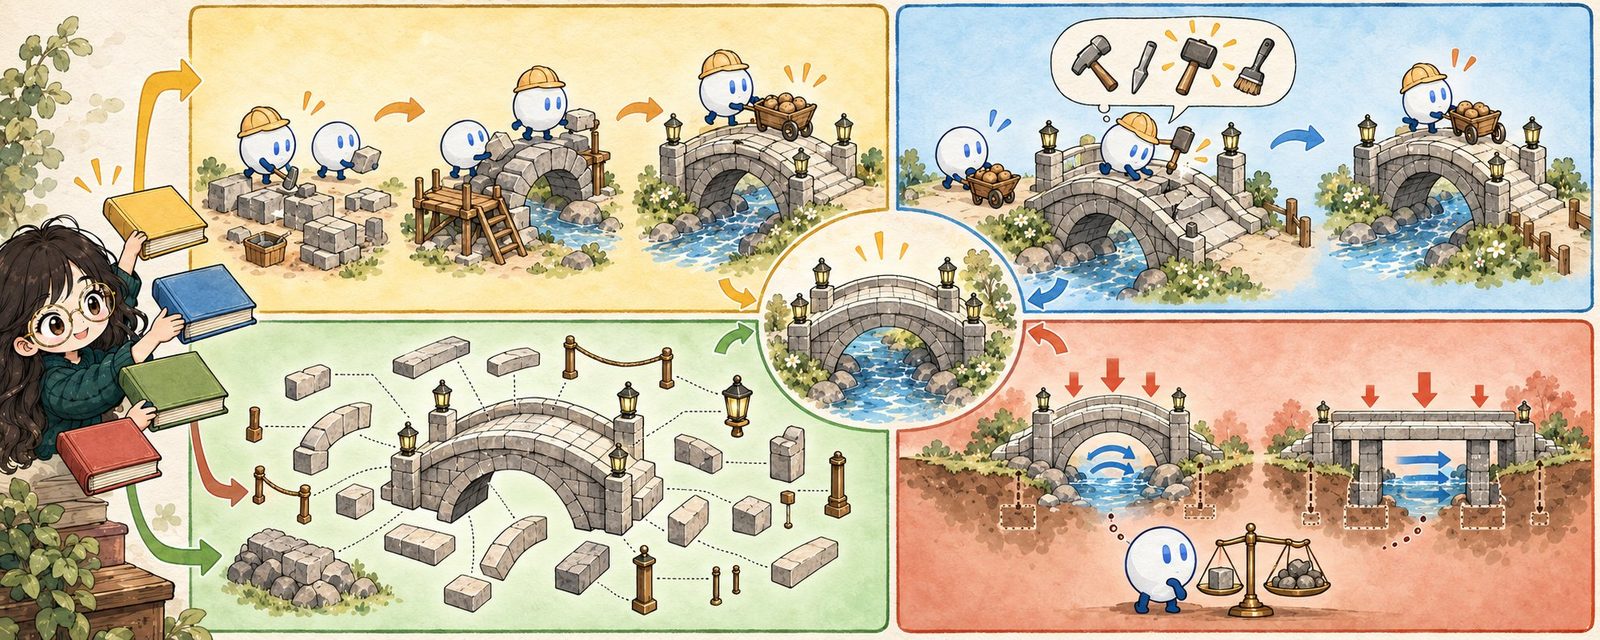
/technical-writing 用 Diátaxis 框架把文档切成四种截然不同的模式:
- Tutorial:做中学。一节课带新人走完一串步骤,做出看得见的东西。
- How-to guide:面向有经验的用户,解决一个具体、真实问题的步骤。
- Reference:干巴巴、完整、权威的技术描述,讲机制、API 和配置开关。
- Explanation:高层讨论,厘清并照亮背景、设计选择与权衡。
它还会用 /unslop,所以产出的文档非常可读。
这样写计划很有用,因为它同时给了 agent 一个具体的靶子和目标,让它能拿自己的产出去对照检查。当然,你也会更容易看清 agent 到底要建什么。
pstack 的很多 skill 在设计阶段会在这里彼此叠加。比如:
(1)/recall 我过去 7 天修虚拟化 bug 和性能问题的工作。用 /how 和 /why 搞清楚我们现在的虚拟化实现是怎么回事。(2)然后用 /poteto-mode 规划和 /technical-writing,提出一套能从根子上消除闪烁和抖动的新虚拟化引擎。先写一份 tutorial,讲我会怎么用这个新包来虚拟化一个 React 应用(3)写完计划后,/teach 我,并向我证明为什么这套新方案优于现在的引擎
这里的技巧,本质是把有意思、有厚度的上下文引出来,让 agent 能像你一样看待问题,而不只是看到一个小切片:
- 提示的第一部分,召回我的应用里虚拟化如何实现的相关历史与当下上下文。
- 第二部分引导 agent 用上这些上下文,比如它以前修过的 bug,去提出一套能彻底消除这些问题的新设计。
- 最后一块,是让 agent 向你证明这个新包更优。这正是验证 skill 这类高质量工具重要的地方。
量一百次,剪一刀
Section titled “量一百次,剪一刀”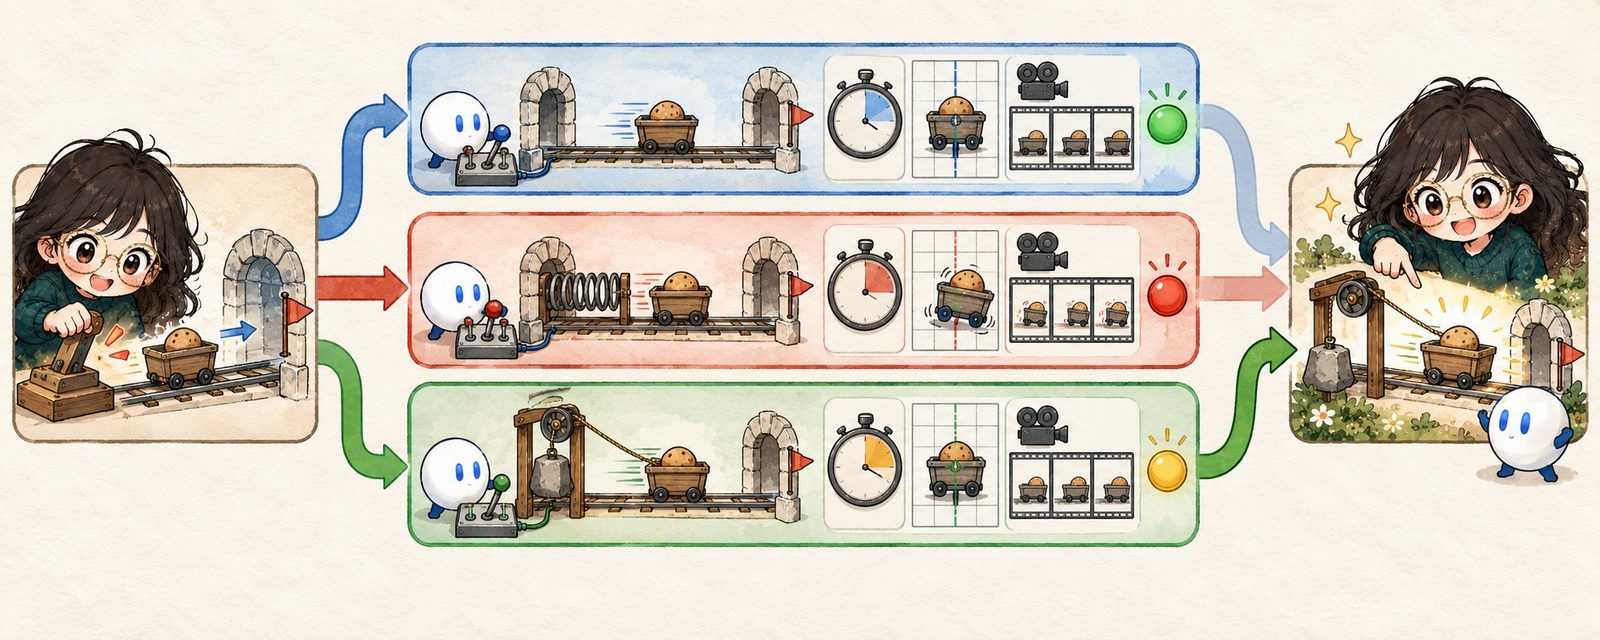
规划时我最常见到的两个错误是:
- 接受 agent 给的第一版设计。
- 在没有经验证据的情况下把计划炖过头。
当代码还由人类来写的时候,我们常常围绕设计文档彼此协作。这些文档讲高层架构、考虑过的替代方案、权衡,以及任何不寻常的实现说明。在落定一个设计之前,这类文档过好几轮迭代是很常见的。
有了 agent,设计文档那套仪式可以省掉,但我常看到的错误是,接受 agent 回给你的第一个东西。在 pstack 里,我们可以反过来把「量两次,剪一刀」推到极致,用并行 agent。
做法是使用原型 playbook。
在 pstack 里,playbook 不是 skill,而是 /poteto-mode 内部的参考文件。这些 playbook 按你手上任务的类型条件加载,为的是省 token。这 23 个 playbook(截至 0.15.0)各自装着我做某类任务时用的一套工作流。
和 skill 不同,playbook 由 agent 作为 /poteto-mode 的一部分自动使用。比如:
/poteto-mode 给新的下拉菜单原型几个方案/poteto-mode 修这个 bug/poteto-mode eval 这次 skill 改动
原型是我最喜欢的 pstack playbook 之一。它给你对同一个目标的多次尝试,并帮 agent 推理出最好的那个。这不只对视觉原型有用,对功能、bug 修复等不同解法做原型同样有用。
/poteto-mode 给 <功能需求> 原型几个方案。用 /control-app*,录视频或截图给我 review 并挑选
*注:/control-app 是我们在第 1 部分里创建的验证 skill
做视觉改动的原型时,agent 会在你的应用里或某个临时目录里搭一次性草模。如果它在测一种 UI 交互,它会把两三个变体放在一个简单的切换器后面。然后它用 /control-app skill 驱动这个交互,给每个变体截图,并测量真实的时序或布局。
原型就是规划,只不过是用代码规划。它让 agent 有自由去探索问题空间,也给了它用你自己想不到的东西给你惊喜的机会。原型让 agent 能用经验证据回答自己的问题,而不是干等我的输入。
为更大的变更做架构
作为 agent 时代的工程师,把时间花在架构、选对数据结构、思考我建的这些系统将如何协同,变得更重要了。实现细节交给我的 agent 填。
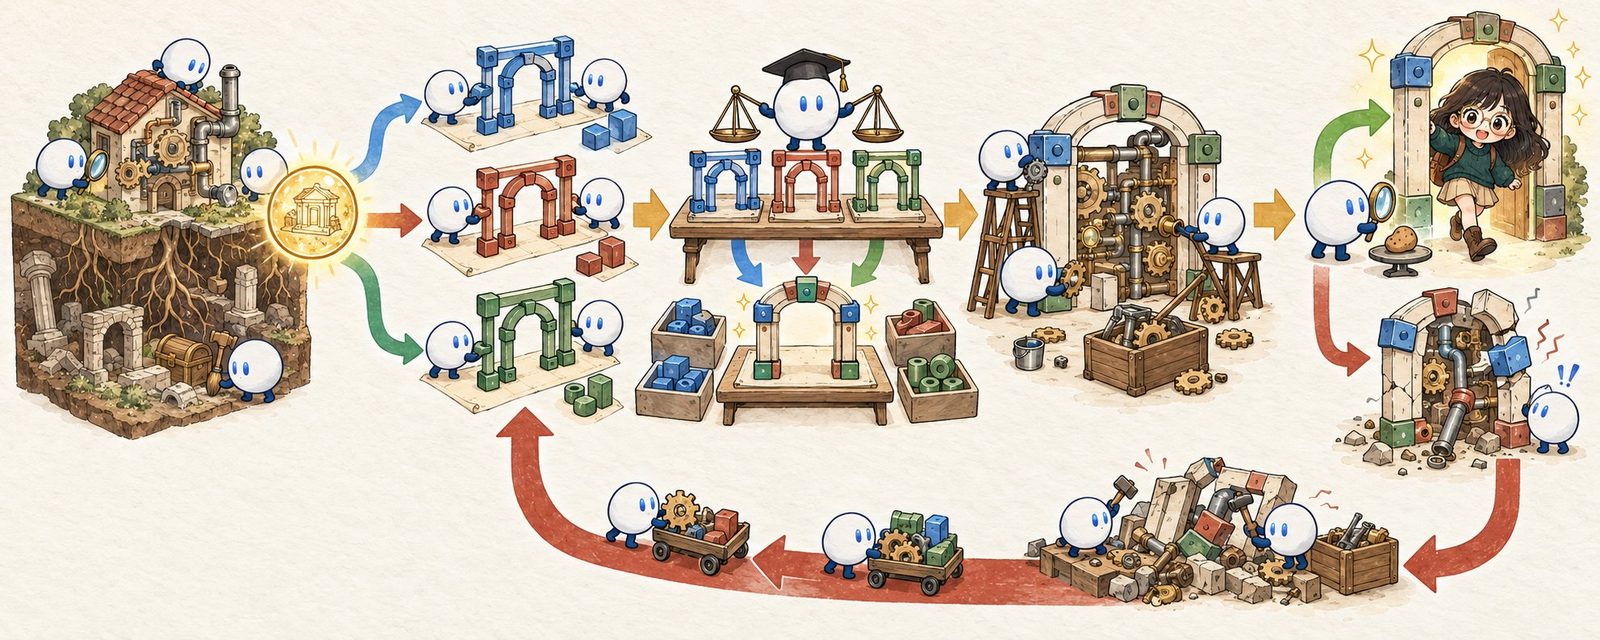
pstack 自带的另一个有用 skill 是 /architect。它把设计拆成几个界限分明、讲纪律的阶段:
- 锚定问题。agent 对受影响的系统跑 /how 和 /why,建立关于现有归属与约束的准确心智模型。
- 起草。agent 进入一个架构 arena。它并行 spawn 独立的候选 runner,常常跨不同的模型家族。每个 runner 拿到锚定简报,起草一份完整的设计包,包含调用方的用法草图、核心类型定义、公开函数签名,以及一段简明的理由。这些通常只写出类型签名,而类型签名是从我们希望 call site 长成什么样推导出来的。每个 runner 必须评估接口深度、在弱模型上检视失败模式,并对照我们的设计红旗清单做筛查。
- 交叉评判与综合。一个使用不同模型的 cross-judge agent,按一份严格的评分标准评估各个候选。
- 照草图实现。agent 把草图里的占位函数体换成真正的逻辑。如果实现过程中发现某个函数需要意料之外的参数或额外状态,它会把这个不一致暴露出来。
- 设计错了就推翻。如果实现中发现草图是错的,agent 会全部扔掉重来。
这里的要点,是给 agent 一个自洽的小循环,让它能把来自不同模型家族的多套竞争设计综合成一套最优方案,并且保持严谨,在经验证据表明架构错了时不怕把自己的设计扔掉。如果同一个 workaround 出现在互不相关的 call site 上,或者类型需要 any 这类逃生舱和强制转换,那就是架构错了的经验证据。
/architect 这个新的 <功能需求>
这里的大教训是,用 /poteto-mode 的原型和 /architect 以代码来规划,要有效得多。
这也是为什么我从不费心去对抗式地 review 抽象计划。agent 会开始幻想理论风险,编造复杂的边界情况,去防御那些永远不会发生的问题。计划还停在抽象阶段时不要炖过头,让 agent 通过做原型、验证自己的工作,去回答悬而未决的问题。
好吧,可我就是想要一份规划文档
Section titled “好吧,可我就是想要一份规划文档”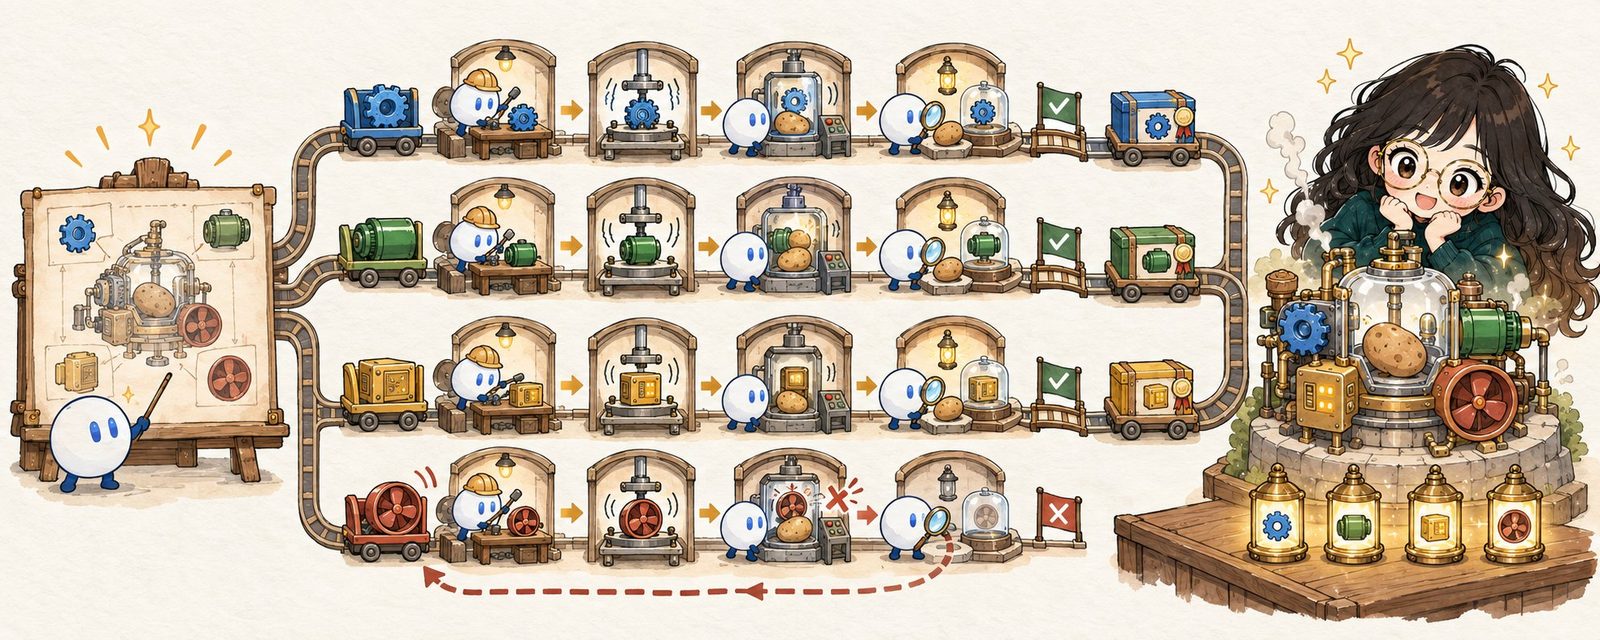
虽然 pstack 不带规划 skill,它确实自带一个多阶段规划 playbook。我通常在 agent 拿出一个我满意的设计之后才用它,用来做一份战术层面的执行计划。
/poteto-mode 把这个设计变成计划
计划里的每一项任务都围绕证明与验证来组织。这个 playbook 告诉 agent,光有测试不算充分验证。只有真的跑过代码并验证它能工作,才算验证通过。
每份计划都由一个自动脚本检查,校验它的结构与格式。一旦通过,计划就逐项执行。每个 PR 都小而自洽,容易 review。
对真正的大项目(比如要花掉我一整周的那种),我有时会决定把计划临时 commit 进代码库,好让其他 agent 知道有这么一摊工作在进行中。但做完我通常会删掉,免得给代码库留下一片困惑。我不觉得把计划长期留着有什么价值。
这套工作流在实践中长什么样
Section titled “这套工作流在实践中长什么样”为了看清这些零件怎么拼在一起,我们来过一遍三个具体例子,看我是怎么提示这些工作流的。
例 1:调研一个含糊不清的 bug
Section titled “例 1:调研一个含糊不清的 bug”当问题出现在生产环境,而根因不明时:
/poteto-mode 调查后台 worker 为什么周期性地以超时错误失败。给我一份梳理,说明我们已知什么、你用了哪些数据、你最好的几个假设是什么。
agent 会探索代码,并行检查指标和历史 commit,然后给你关于问题可能出在哪里的最佳有据推测。
例 2:设计一条新的服务边界
Section titled “例 2:设计一条新的服务边界”当你要引入一个其他模块会依赖的新子系统时:
/poteto-mode 我们需要给外部 webhook 加限流。先 /architect 这件事,用原型回答所有悬而未决的问题。进行下一步前让我 review。
agent 会锚定现有的 webhook 架构,跨多个模型拉起互相竞争的设计 runner,用一次性原型做基准测试,产出一个干净、已验证的接口。
例 3:执行一次多 PR 迁移
Section titled “例 3:执行一次多 PR 迁移”当你要在很多文件上执行一次复杂重构时:
/poteto-mode 制定一个把我们整个 UI 库迁移到 StyleX 的计划。把迁移拆成小而可验证的 PR。每个 PR 都必须带上自己的视觉回归测试和实时验证步骤。我要最终结果和原来 100% 一致,连 bug 都一样
agent 会把工作拆成互相独立的步骤,写一份可审计的检查清单,并把每个单元准备好,使它能被构建、验证并安全落地。
例 4:修大家在 Slack 上反馈的东西
Section titled “例 4:修大家在 Slack 上反馈的东西”如果你在我们的 issue 或反馈频道里见过我,大概见过这几句经典的:
thread 里已经有足够上下文/poteto-mode 就这么干/poteto-mode 用 /control-app 复现这个。如果在 main 上能复现,就修掉,并给我一段视频作为证明
Section titled “thread 里已经有足够上下文/poteto-mode 就这么干/poteto-mode 用 /control-app 复现这个。如果在 main 上能复现,就修掉,并给我一段视频作为证明”
我这里讲到的很多 skill,/poteto-mode 已经会自动用上,所以绝大多数时候你只管用 /poteto-mode,然后继续过你的日子就行!
规划这门手艺
Section titled “规划这门手艺”Plan Mode 常被用来说服你自己,让你相信 agent 会做对的事。但现实是,抽象计划只给你进展的错觉。一份又长又啰嗦的计划让你和你的 agent 看起来很高产,实质却多半不足。
pstack 给你的工具,把彻底的调研、经验证据和严格的验证结合在一起。当你这样规划时,和 agent 一起做工程就不再像赌博。它变得可预测、可复现。
感谢阅读,敬请期待第 3 部分!